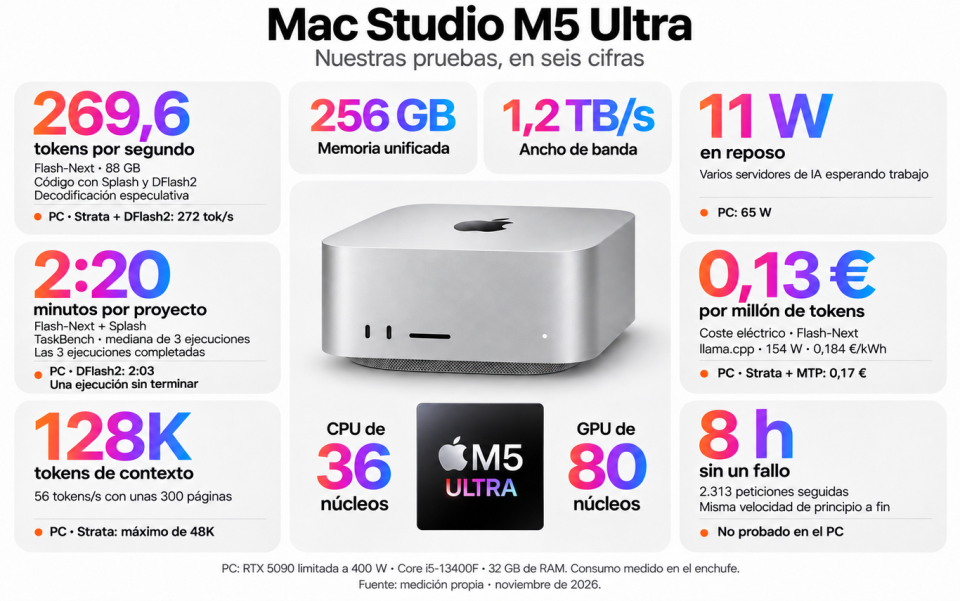
Hay una pregunta obvia cuando uno se sienta delante del ordenador más caro y potente que jamás ha probado: ¿para qué quiere nadie pagar más de 16.000 euros por un Mac Studio con 256 GB de memoria unificada? La respuesta corta es, cómo no, la de ejecutar modelos de IA localesPorque lo que nos hemos propuesto es hacer una (laaarga) exposición de por qué un equipo así puede tener sentido y para quién. Llevamos más de un mes analizando el Mac Studio M5 Ultra 256 GB y el objetivo era intentar exprimirlo al máximo y tratar de medir sus límites. Y de hacerlo específicamente en el ámbito para el que claramente esta máquina bestial ha sido creada: la ejecución de modelos locales de IAEn estos últimos cuatro años si uno quería sacar partido de un modelo de IA, lo más normal era aprovechar no el suyo propio, sino el de otros. Todo este tiempo hemos estado escribiendo prompts en una web (la de ChatGPT, la de Claude, la de Gemini, etc) o en algún entorno de desarrollo, por ejemplo OpenCodePero al hacerlo sabemos perfectamente que todo lo que escribimos llega a algún centro de datos que procesa nuestras peticiones y acaba devolviendo una respuesta cada vez más precisa y rápida.
Eso tiene ventajas evidentes, pero también costes: cada consulta se paga y dependemos de servicios que obviamente no controlamos y pueden cambiar de un día para otro. Lo hemos visto en el pasadoLa alternativa es ejecutar esos modelos de IA en tu propia máquina, algo que hasta hace no mucho era una curiosidad para entusiastas. Sin embargo las cosas han avanzado de forma vertiginosa, y hoy hay modelos abiertos de IA estupendos que programan, resumen, traducen y razonan lo bastante bien como para trabajar con ellos sin demasiados problemasEl único problema es que esos modelos suelen ser enormes, y ahí es donde entra un equipo como el Mac Studio con chip M5 Ultra y con 256 GB de memoria unificada, que es como comentábamos el que hemos estado utilizando desde hace algo más de un mes.
No lo hemos aprovechado para jugar o editar vídeo, aunque haga ambas cosas —lo contaron muy bien nuestros compañeros de Applesfera—, sino para responder a una pregunta concreta: ¿qué se puede hacer con IA local en la máquina más potente que vende Apple hoy en día… y cuánto de eso se puede conseguir con menos inversión?
Para responder a dicha pregunta hemos montado un pequeño laboratorio de pruebas con decenas de horas de mediciones automatizadas, siete modelos distintos, siete motores de inferencia, sesiones de ocho horas ininterrumpidas, pruebas de programación real con agentes, y hasta un vatímetro en el enchufePara entender todas las cifras con las que iremos llenando este artículo conviene entender qué ocurre cuando le haces una pregunta a un modelo local «accesible» como Qwen3.8 27B o Gemma 4 31BHay dos fases muy distintas al usar un modelo de IA, sea no local, y casi todo lo que interesante que verás en este análisis sale de esa distinción. Y a ellas se les suma un concepto igualmente importante para la experiencia de usuario. Veamos los tres
- Lectura (prefill): en esta primera fase, el modelo recibe todo tu texto, tanto si es una pregunta de una línea como un documento de cien páginas, y lo procesa de golpe. Aquí tenemos la ventaja de que esta tarea se puede paralelizar muy bien: todas las palabras del texto se pueden procesar a la vez, así que lo que manda en este caso es la potencia de cálculo bruta de la GPU, que es muy, muy buena en este tipo de ámbitos. Aquí medimos el rendimiento en número de tokens por segundo leídos, y como ya explicamos hace tiempo, un token es un trozo de una palabra, que usalmente se aproxima a tres cuartos de una palabra de media.
- Escritura (decode): la segunda fase es la que produce la respuesta del modelo token a token, y aquí está lo importante de los modelos de IA generativa, que se comportan como loros estocásticos que eneran el siguiente token a partir de probabilidades: cada token nuevo depende del anterior. Lo malo es que para generar un token hay que leer toda la memoria previa, aunque aquí influyen otras cosas, como veremos más adelante. Si el modelo ocupa 20 GB —Qwen3.8-27B ocupa más o menos eso—, para cada token es necesario leer de la memoria esos 20 GB. Por eso la velocidad de escritura o decodificación depende de los GB/s que puede mover el chip, y no tanto de su potencia de cálculo. El procesador gráfico no es aquí tan importante, pero sí lo es la memoria.
- Tiempo hasta el primer token: este es el tiempo que tardamos en ver la primera letra de la respuesta, y depende casi por completo de la primera fase de lectura. Leer un prompt corto es inmediato, así que la respuesta comienza a generarse enseguida. Para un documento de 128.000 tokens, como verremos, esa espera puede acabar siendo de minutos.
Por todo ello, verás que en nuestras pruebas hemos medido siempre esas tres magnitudes: lectura, primer token y escritura. Una cifra sola engaña, o al menos no nos da la foto completa: un equipo puede escribir muy rápido y tardar una eternidad en leer un documento, y viceversa.
La memoria importa, y mucho
En un PC con tarjeta gráfica, esa GPU tiene siempre su propia memoria de vídeo (VRAM), que está separada del sistema. Si el modelo de IA local «cabe» en esa VRAM, irá rapidísimo, pero si no, habrá que repartirlo entre esa memoria gráfica o de vídeo y la memoria principal del sistemaAhí surge un problema y el rendimiento se desploma, porque la conexión entre ambas es mucho más lenta que la memoria de vídeo de la GPU. Las tarjetas de consumo más potentes, como la Nvidia GeForce RTX 5090, tienen 32 GB de VRAM. Eso significa que modelos como Qwen3.8-Flash-Next, que ocupa unos 90 GB, no «cabe» en ellas. Al menos, no directamente, porque hay motores que reparten modelos grandes con mucha habilidad, pero eso es materia para otro artícuo
